
 文:張恭銘
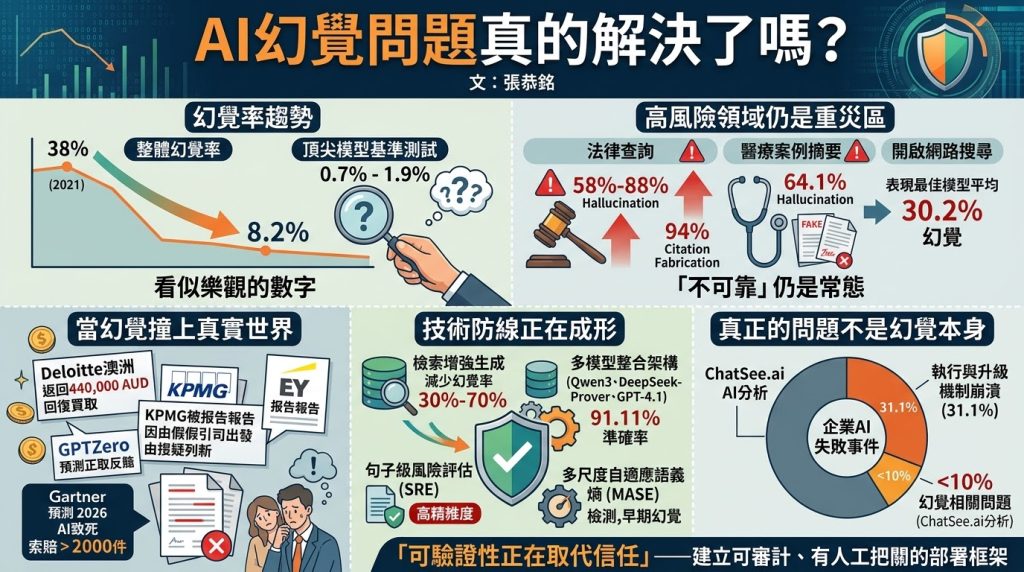
2021年至今,大型語言模型的整體幻覺率從38%降至8.2%,頂尖模型在特定基準測試中錯誤率甚至壓至0.7%至1.9%。但這個看似樂觀的數字,掩蓋了一個關鍵事實:幻覺率的下降並未平均分布於所有應用場景。
高風險領域仍是重災區
史丹佛大學研究發現,主要LLM在法律查詢上的幻覺率介於58%至88%之間,引用文獻的捏造率更高達94%。生成醫療案例摘要模型的幻覺率可達64.1%,法律AI工具即便在最佳狀態下仍有17%至34%的錯誤輸出。2026年2月一項研究更揭示,即使開啟網路搜尋功能,表現最佳的模型平均幻覺率仍達30.2%。換言之,模型能力在提升,但在需要精確輸出的專業場景中,「不可靠」仍是常態。
當幻覺撞上真實世界
問題已從學術討論走進企業財報。Deloitte澳洲分公司因使用GPT-4o撰寫政府諮詢報告,產生捏造的法律判決與論文引用,被迫退還44萬澳幣諮詢費。KPMG一份關於AI代理的研究報告被GPTZero查出45條引用中僅5條正確指向來源,其餘要麼誤導、要麼部分捏造、要麼模糊到無法核實,最終緊急下架。EY也因報告包含虛假腳註與AI幻覺而撤稿。Gartner預測,到2026年底全球「AI致死」法律索賠將超過2000件,AI保險產品已開始覆蓋幻覺造成的財務損失。
技術防線正在成形
檢索增強生成(RAG)是目前最核心的緩解方案,透過外部驗證文件錨定模型輸出,可將幻覺率減少30%至70%。多模型整合架構方面,一項2026年IEEE研究顯示,結合Qwen3、DeepSeek-Prover與GPT-4.1的混合驗證系統將準確率推升至91.11%,超越單一模型最高86.67%的表現。句子級風險評估框架(SRE)在CNN/DailyMail等基準上達到0.85的精確度與0.80的F1分數,能逐句標記高風險內容。多尺度自適應語義熵框架(MASE)則在生成的前5個token內即可檢測出73%的幻覺,並降低70%的檢測成本。
真正的問題不是幻覺本身
值得注意的是,ChatSee.ai分析超過一萬起企業AI失敗事件後發現,幻覺相關問題如今僅占企業AI失敗的不到10%,執行與升級機制的崩潰才是更大的風險來源,占比達31.1%。這意味著討論焦點正從「模型會不會胡說」轉向「AI在關鍵流程中的可靠性如何被系統性保障」。對企業而言,與其追求零幻覺的技術烏托邦,不如建立可審計、可追溯、有人工把關節點的部署框架——在AI時代,可驗證性正在取代信任,成為新的商業基礎設施。