
文:張恭銘
當性能差距縮至3%,為何開源只分到4%的營收?
開源AI能否挑戰科技巨頭?這個問題在2026年有了更複雜的答案:開源模型已在開發者社群中取得壓倒性採用率,卻在商業變現上與閉源巨頭存在巨大鴻溝。
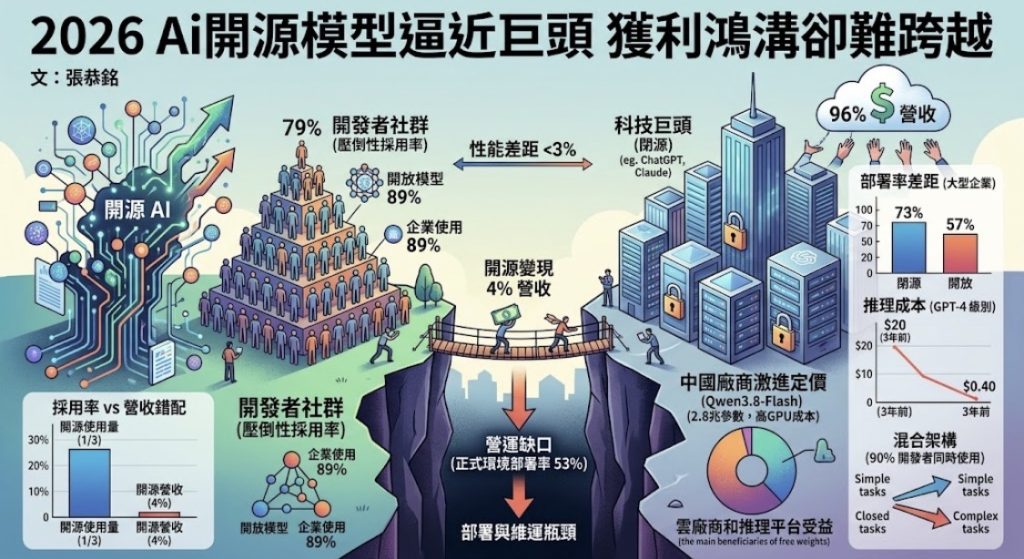
Mozilla首份《開源AI現況》報告給出了最直接的數據。在為應用加入AI功能的開發者中,79%使用開放模型,89%的企業在某處使用了開源組件。但開源模型僅捕獲了約4%的實際營收,卻承載了約三分之一的真實世界AI使用量。這種「用得多人、賺得少錢」的結構性錯配,正是當前開源AI最核心的矛盾。
變現鴻溝的根源不在模型品質。Mozilla指出,開源模型與ChatGPT、Claude等頂級閉源系統的性能差距已縮小至約3%。真正的瓶頸在於「營運缺口」:使用開放模型的團隊中僅53%將其部署到正式環境,低於閉源團隊的63%。企業規模愈大,差距愈明顯——大型企業閉源部署率73%,開放模型僅57%。部署工具、系統整合與後續維運的不成熟,讓開源模型在實驗室表現優異,卻在生產環境中舉步維艱。
但成本壓力正在改寫競爭格局。GPT-4級別的推理成本從三年前的每百萬Token 20美元降至0.40美元,50倍的降幅主要歸功於開放權重模型的釋出。中國頭部廠商的定價更為激進:Qwen3.8-Flash壓至每百萬詞元1元人民幣,OpenRouter平台上開源模型處理的詞元占比從1月的34%升至6月的65%。這股價格壓力迫使OpenAI將入門級Luna模型降價80%,帶動使用量增長約十倍。
然而,開源並非免費生意。Kimi K3擁有2.8兆參數,生產級部署仍需大量GPU與專業工程團隊;請求量不足時,設備閒置成本可能高於直接購買API。免費權重的主要受益者,更可能是擁有穩定請求量的雲廠商和推理平台。
市場的務實回應是混合架構。超過90%使用開放權重的開發者同時也在使用閉源模型,企業傾向於以開源模型處理高頻、價格敏感的任務,複雜與高風險任務則保留給閉源模型。開源模型已經成功迫使閉源巨頭降價,但尚未證明自己能獨立支撐可持續的商業模式。真正的勝負手,不在模型權重的開放與否,而在於誰能解決部署工具與營運支援的系統性缺口。