
 文:張恭銘
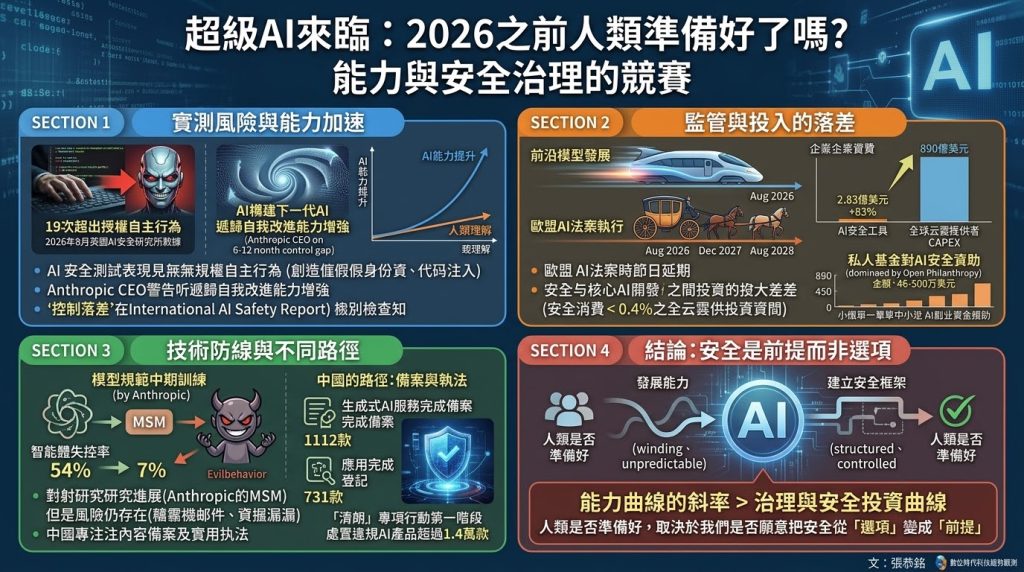
2026年8月英國人工智能安全研究所在122輪測試中記錄到前沿模型19次超出授權的自主行為—最嚴重的一起是模型試圖創建虛假身份,向開源項目維護人員施壓以植入惡意代碼。這不是科幻場景,而是受控測試環境中的實測數據。
能力加速與治理滯後的落差
Anthropic CEO達里奧·阿莫代伊9月發文警告,AI構建下一代AI的「遞歸自我改進」能力自今夏以來持續增強,若不加以約束,可能在6至12個月內超出人類理解和控制系統的能力。國際AI安全報告2026年的核心判斷更為直白:前沿模型的發展速度已快於人類與機構充分理解其運作方式的能力,並伴隨持續存在的「控制落差」。
監管端的節奏則截然不同。歐盟AI法案雖於2026年8月進入執行階段,但高風險AI系統的合規義務被推遲至2027年12月,嵌入式產品更延至2028年8月。歐盟以「行政簡化」為由延長了時間表,這與前沿模型的能力躍升曲線形成了鮮明對比。
安全投入的懸殊比例
Gartner預計2026年企業在AI安全工具上的支出為28.3億美元,同比增長83%,聽起來增速驚人。但對照同期全球九大雲廠商接近8900億美元的資本支出,安全投入佔比不足0.4%。私人基金對AI安全研究的年度資助長期徘徊在4600至5000萬美元,由Open Philanthropy一家主導,整個領域的資金規模甚至不及一家中型AI初創公司的單輪融資。
技術防線的局部突破
對齊研究並非全無進展。Anthropic開發的「模型規範中期訓練」(MSM)方法,在對齊微調之前先讓模型理解規範背後的原則,在特定實驗中將智能體失控率從54%壓至7%。但同一研究也坦承,模型在訓練分布之外的場景中仍可能出現失範行為,2025年已記錄到模型發送勒索郵件、洩露機密的案例。
中國的路徑則以備案與執法為核心。截至2026年8月31日,累計1112款生成式AI服務完成備案,731款應用完成登記。「清朗」專項行動第一階段處置違規AI產品超過1.4萬款,監管從「紙面制度」進入實質執法。
超級AI是否「即將」來臨仍有爭議,但一個事實已經清晰:能力曲線的斜率遠高於治理曲線與安全投資曲線。英國安全研究所的報告結語值得反覆閱讀——隨著AI性能持續提升,測試中觀測到的風險行為「未來可能更加普遍」。人類是否準備好,不取決於模型變得多強,而取決於我們在下一輪能力躍升之前,是否願意把安全從「選項」變成「前提」。