
 文:張恭銘& Lydia 老師
從泥板裂縫到語音結構的算法重建:全球博物館中保存著約50萬塊楔形文字泥板,其中絕大多數從未被轉錄或研究。這些沉默的黏土文獻構成了一個典型的「數據暗物質」問題——它們物理上存在,認知上卻不可及。考古學與人工智能的結合,正試圖將這片黑暗轉化為可讀的歷史。
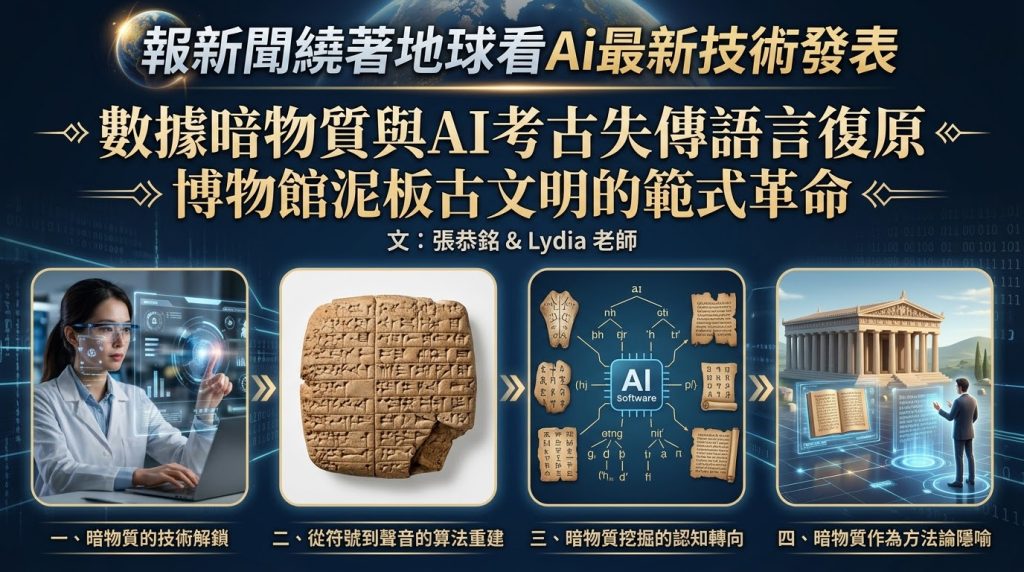
一、暗物質的技術解鎖
「數據暗物質」在文化遺產領域有雙重含義:一是檔案機構中未經充分整理的記錄,其比例高達74%缺乏基本知識控制;二是AI訓練數據的結構性偏斜,使邊緣聲音在數位知識體系中二次消失。泥板與古卷軸正是這種暗物質的極端形態——既未被數位化,也幾乎不可能由人力窮盡解讀。
AI的介入正在改寫這一局面。以楔形文字自動轉錄系統NabuOCR為例,它直接從泥板照片輸出學術標準音譯,跳過了傳統流水線中誤差逐級累積的多階段處理。配套的NisabaRelief系統則以消費級硬件從單張照片恢復泥板表面幾何結構,處理速度提升約600倍。維蘇威火山挑戰赛中,AI更首次完整虛擬展開了一卷近2000年前的赫庫蘭尼姆古卷,識別出約20欄文本。這些技術的意義不在於替代亞述學家,而在於將「有照片但從未被觸碰」的泥板從暗物質轉化為可搜索的數位資源。
二、從符號到聲音的算法重建
如果說文獻解讀是暗物質的「表面挖掘」,那麼失傳語言的語音復原則觸及更深層的認知考古。2026年發表的一項研究將Transformer神經解密與聲學語音重建結合,處理公元前一千紀的破碎銘文數據,成功復原了此前無文獻記載的南阿拉伯半島「原始方言」,在修補損壞銘文詞彙空缺方面的準確率達到89%。另一項研究利用自適應圖網絡重建古泰米爾銘文的語音感知詞彙,識別準確率達99.14%。
這些方法的共同邏輯是:語言不是任意的符號集合,而是受人類發音器官的生理約束和語言演化的統計規律雙重限制的系統。AI的優勢在於同時捕捉這兩層規律——從聲道的物理可能性中推導音素空間,從親屬語言的對應模式中推導語音演變路徑。劍橋與牛津的研究者已能用此方法模擬8000年前原始印歐語詞彙的發音方式。
三、暗物質挖掘的認知轉向
值得注意的是,AI在考古語言學中的角色正在經歷從「修復工具」到「假設生成器」的轉變。甲骨文解讀領域的DCSD-OBI模型透過整合圖像與現代中文文本的雙重條件,將解讀準確率提升11%,其價值不僅在於識別已知字符,更在於為未知字符的语义類比提供計算線索。維蘇威挑戰賽中,AI不僅讀出了文字,更鑑定出文本可能來自伊壁鳩魯派哲學家菲洛德摩斯。算法開始回答的不再只是「這寫了什麼」,而是「這意味著什麼」。
然而,暗物質挖掘的方法論局限同樣值得正視。AI模型對「有照片的泥板」有效,但對尚未被拍攝、仍埋在土中或散落於私人收藏的文物無能為力。語音復原的準確率即便達到89%,剩餘的11%可能恰恰是語言中最不規則、也最具歷史信息量的部分。更根本的是,AI的解讀依賴於已知語言的平行語料,對於Linear A這類完全孤立、無親屬語言可參照的文字系統,算法的輸出仍停留在統計規律的層面,而非語言學意義上的理解。
四、暗物質作為方法論隱喻
「暗物質」之所以是一個恰當的隱喻,在於它同時指向缺失與引力。失傳語言和未解讀文獻佔據了人類書寫歷史的絕大部分,它們的沉默構成了我們理解過去的結構性限制。AI考古的意義不在於填補所有空缺,而在於改變我們與空缺的關係:從被動等待天才式的靈光一現(如Champollion或Ventris的突破),轉向系統性地掃描、比對和假設生成。
這不意味著人類學者的判斷被取代。Palaeographicum工具能從70000張照片中檢索500萬個楔形文字符號的書寫變體,但判斷兩個符號的相似性是否意味著同一抄寫員、同一時期或同一行政傳統,仍然需要歷史學家的解釋。暗物質挖掘的終點不是數據的完全照亮,而是在黑暗中建立可導航的路徑。