
 文:張恭銘
2026年9月,一批解封的法庭文件讓科技業最不願公開的內部對話攤在了陽光下。微軟應用科學總監布倫特·赫克特(Brent Hecht)在2023年1月的內部備忘錄中,將AI訓練的資料抓取行為定性為「人類歷史上最大規模的勞動竊取」,並稱其為「一次規模空前、令人震驚的竊取」。同一份文件裡,ChatGPT負責人尼克·特利(Nick Turley)則坦承,AI對新聞出版商構成「生存層面的威脅」,且「性能越強,替代性就越強」。
這些話不是外界批評者的指控,而是來自正在建造這些系統的人自己。它們揭示了生成式AI產業一個難以迴避的結構性矛盾。
一條正在吞噬自己的供應鏈
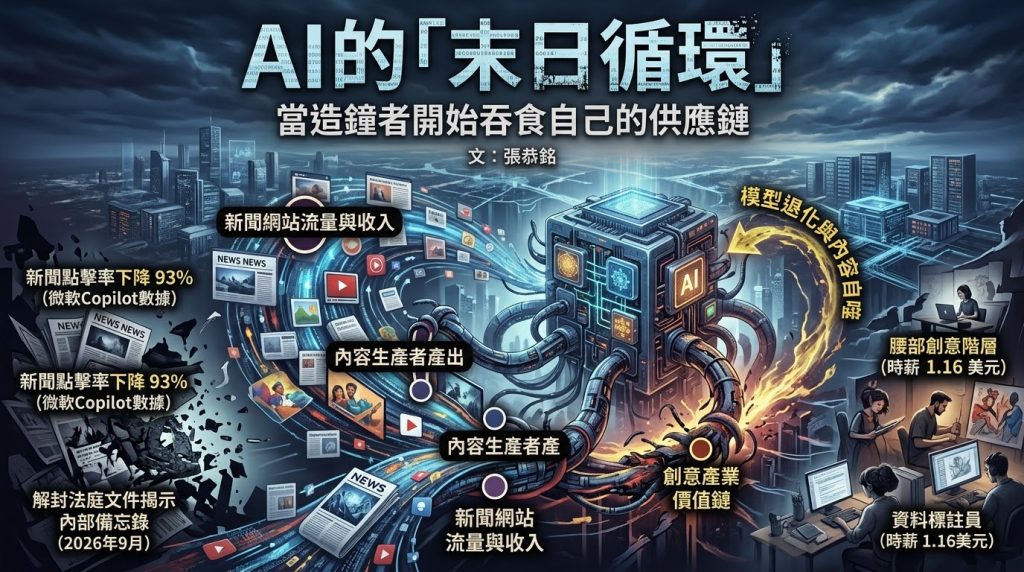
赫克特在2024年1月的內部簡報中用「毀滅循環」(doom loop)來描述這個困局:AI產品持續削減新聞網站的流量與收入,導致內容生產者減少產出,最終使AI模型本身失去可靠、優質的訓練來源。微軟自家數據顯示,其Copilot問答引擎使nytimes.com的點擊率較傳統Bing搜尋最多下降了93%。赫克特寫道:「終端產品威脅到其關鍵供應商的經濟基礎,這種情況極為罕見,但這正是我們為自家大型語言模型業務所造就的局面」。
這個循環的邏輯近乎自毀:模型越成功,供應商越脆弱;供應商越脆弱,模型的下一代就越缺乏有價值的人類創作來學習。這不是外部性問題,而是商業模式內生的悖論。
「盜竊」的規模不止於新聞
新聞業只是最顯眼的戰場。同樣的邏輯正在創意產業全面展開。處於產業鏈中間層的「腰部創意階層」——剪輯師、字幕翻譯、分鏡設計師——正面臨明顯的職業去技術化與經濟置換風險。好萊塢編劇在2023年罷工中爭取到的保護,到了2026年,許多人發現自己等來的不是新合約,而是AI外包平台上的零工:評估台詞、標註動作、用十幾年的敘事經驗教AI如何寫出更「像樣」的對白。
與此同時,AI訓練的人力供應鏈底層,烏干達的資料標註員時薪約1.16美元,在精密數位監控下為遠方的自動駕駛系統逐幀標註圖像。從被無償抓取內容的創作者,到低薪標註資料的工人,再到面臨替代的專業人士,AI的價值鏈本質上是對人類勞動的兩端擠壓。
訴訟之外的真正問題
《紐約時報》對OpenAI與微軟的訴訟已持續三年,法官目前對AI公司的「合理使用」抗辯持相對開放的態度,川普政府甚至提交了支持OpenAI的意見書。但訴訟結果可能不是最終的裁判者。真正的裁判者將是市場本身:如果內容生產者持續凋零,AI模型的訓練資料庫將不可避免地退化為AI自身生成的「迴聲室」,模型品質的邊際衰減將成為不可逆的趨勢。
微軟與OpenAI的內部憂慮之所以值得認真對待,不是因為它們暴露了一家公司的虛偽,而是因為它們精準地描述了整個產業的系統性風險。當一個產業的核心原料來自於它正在摧毀的對象,可持續性就不再是一個道德問題,而是一個工程問題。赫克特所說的「毀滅循環」,最終吞噬的不會只是新聞業——而是AI自己腳下的地基。